novel-characters
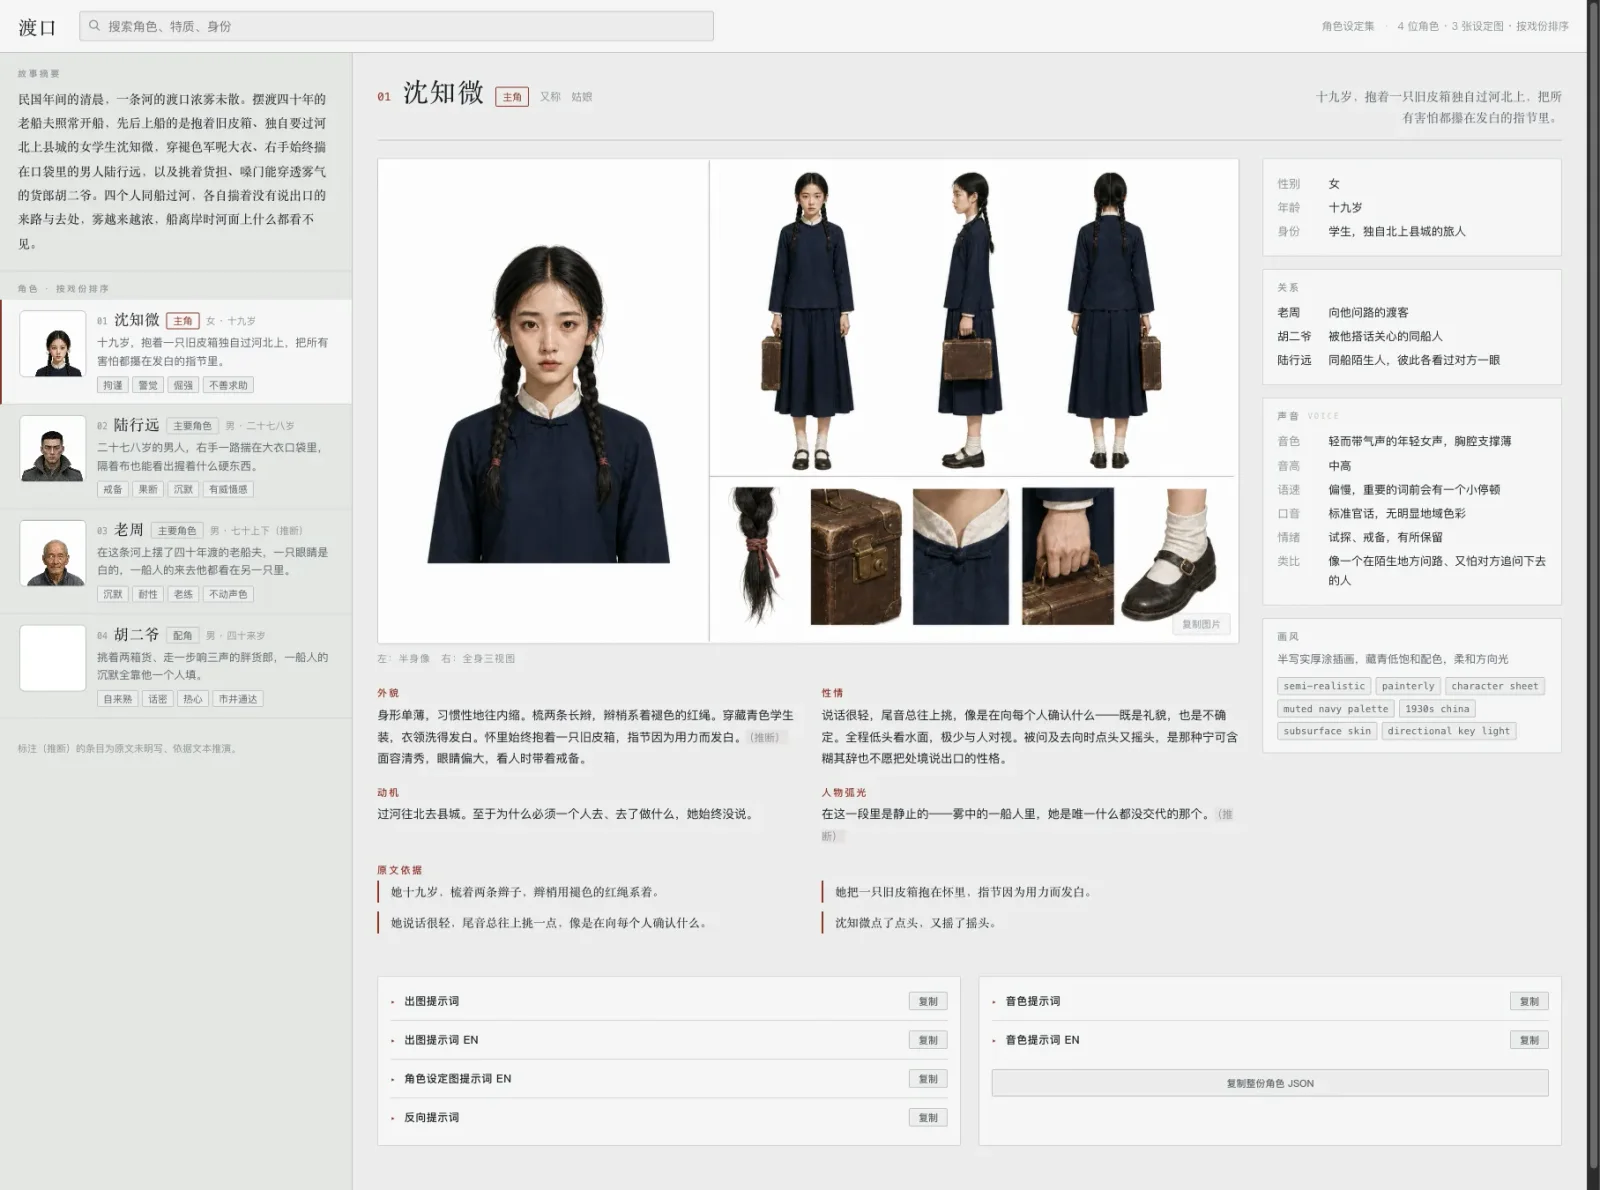
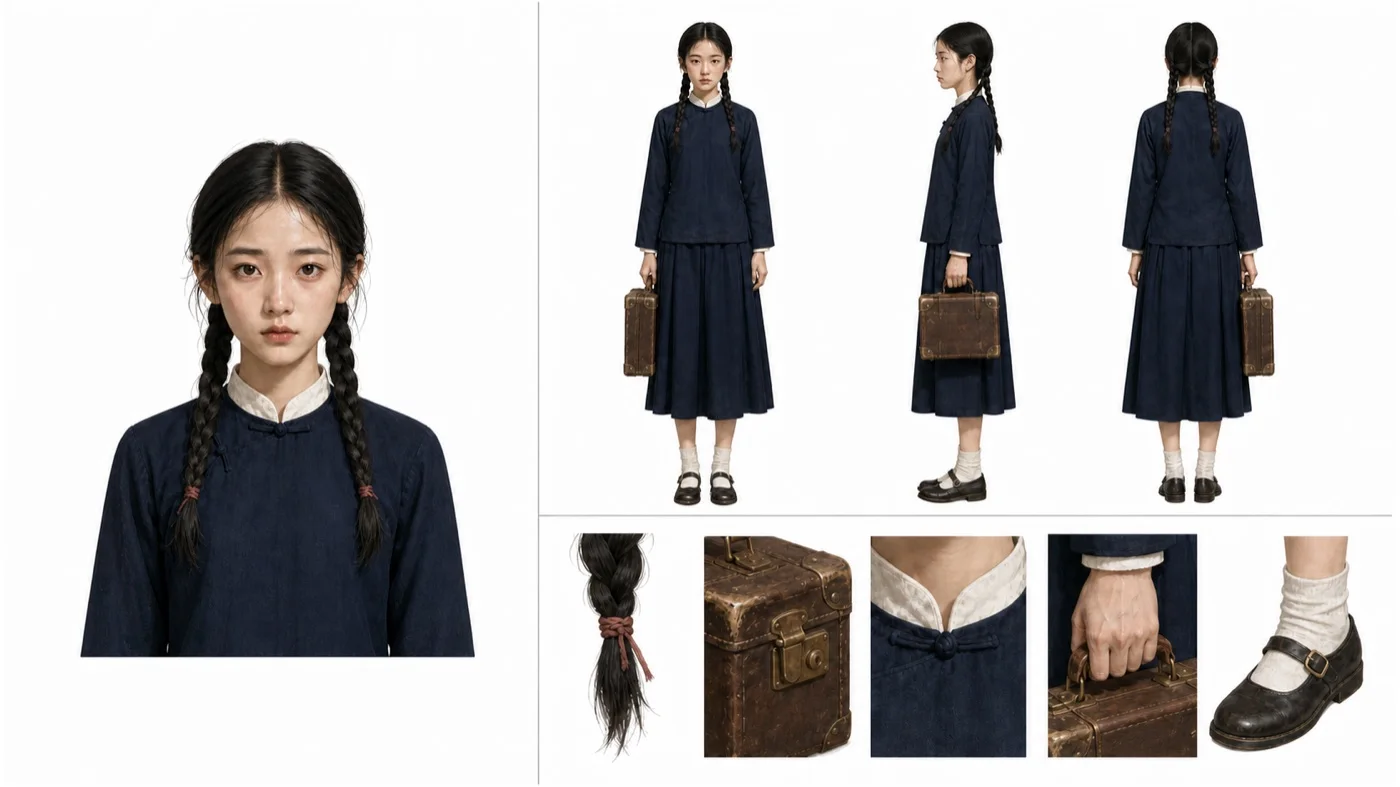
从小说或短故事里拆出角色表、人物画像、形象提示词、音色提示词, 并给每个角色出角色设定图(左半身像 + 右全身三视图 + 细节条),产出 JSON + Markdown + 可交互的 report.html。 报告语言可指定(--lang),默认中文,任意语言都支持; 出图风格可指定(--style),默认半写实,也可以出吉卜力动画风。 零依赖、零 API key,用当前会话额度;出图走 codex 内置 $imagegen(可选)。 Use when asked to 拆小说角色、分析人物、生成角色卡、character sheets from a novel。
eternityspring · 已有 AI 审核记录
安装与使用
运行命令前先阅读来源与依赖说明。复制命令不会自动安装或执行。
npx skills add eternityspring/shuohao-skills --skill novel-characters技能说明
name: novel-characters version: 1.11.0 description: | 从小说或短故事里拆出角色表、人物画像、形象提示词、音色提示词, 并给每个角色出角色设定图(左半身像 + 右全身三视图 + 细节条),产出 JSON + Markdown + 可交互的 report.html。 报告语言可指定(--lang),默认中文,任意语言都支持; 出图风格可指定(--style),默认半写实,也可以出吉卜力动画风。 零依赖、零 API key,用当前会话额度;出图走 codex 内置 $imagegen(可选)。 Use when asked to 拆小说角色、分析人物、生成角色卡、character sheets from a novel。 allowed-tools:
- Read
- Write
- Bash
- Task
- Glob triggers:
- novel-characters
- 拆角色
- 拆书角色
- 小说角色
- 人物画像
- 角色卡
- 三视图
- character sheet from novel
metadata:
license: Apache-2.0
requires:
bins:
- node # >= 18,只用标准库,无 npm 依赖 optional:
- codex # 有才出三视图;没有就只交提示词,其余照常 runtimes:
- claude-code
- codex
novel-characters
输入一篇小说/短故事,输出每个角色的:人物画像、形象提示词、音色提示词、角色设定图。
{baseDir} = 本文件所在目录。脚本 {baseDir}/scripts/novel-characters.mjs,零依赖,node 直接跑。
运行环境:Claude Code 和 codex 都能跑。差别只在第 8 步出图——见 references/sheet.md。
Step 0 — 确定报告语言
用户可以指定语言,比如「用英文」「--lang en」「日本語で」。没说就是中文(zh)。
这个 lang 会一路传下去:第二趟生成角色卡时决定人类可读字段用什么语言,validate 和 render 也都要带上。
界面文案分两种情况:
-
zh/en/ja—— 内置,不用管 -
其他任何语言 —— 你要现场翻一份。跑
node {baseDir}/scripts/novel-characters.mjs ui-template <lang>它打印一份英文骨架,把每个值翻译成目标语言,整块放进
cast.json顶层的ui字段。渲染时会合并进内置表。不给
ui的话validate会直接报错——否则报告会是「角色内容是法语、界面标签是英文」的半吊子状态。
支持的语言不受内置表限制,法语韩语西班牙语都能出完整报告。
Step 0.5 — 确定画风
用户可以指定出图风格:默认 realistic(半写实厚涂),想要动画质感就用 ghibli(吉卜力式手绘赛璐璐)。
node {baseDir}/scripts/novel-characters.mjs styles # 打印预设的完整内容
读 {baseDir}/references/style-presets.md。换风格是整套换——每个预设自带 render / surface / lighting / negative / tags 五块,整块取用,不要混搭。
最容易搞反的是反向提示词:realistic 绝不能禁 photorealistic,ghibli 必须禁。validate 会拦这个。
版面规则(16:9 三区、比例、细节让位)不随风格变,变的只有渲染质感。
Step 1 — 定位输入
用户给文件路径就直接用。直接粘正文的,先落到一个临时 .txt——后面校验「引文是否逐字」要拿原文比对,没有原文文件这步就没法做。
确定输出目录:用户指定就用;没指定就用原书同级目录。
有 outline.json(novel-outline 的产出)就一起要过来,走 seed——大纲是角色设定的上游,它的 characters 块已经定死了角色清单:
node {baseDir}/scripts/novel-characters.mjs seed <outline.json> > <workdir>/seed.json
搬过来的是大纲已经拍板的事实,留空的是这一层才该做的设计:
| outline 的字段 | seed 之后 |
|---|---|
id | 原样保留成角色码——下游 script / storyboard 用它引用角色 |
name | 角色表就照这份,不再自己判断谁该进 |
tier | 映射成 importance:lead → protagonist、support → supporting、functional → minor |
arc | 直接落进 persona.arc |
role / from | 进 seedNote——定位(女主 / 反派)与「由原著的谁合并而来」,扫原文时知道该收哪几条线的戏 |
留空待填:aliases(要读原文才知道)、oneLiner、persona 其余各项、image、voice。seed 出来的是骨架不是成品,直接跑 validate 会报一堆字段缺失,那是预期的——后面 Step 2–6 就是来填它的。
两处口径要守住:
- 大纲定的分档不要推翻。谁重要是改编阶段拍板的事,这一层只负责把定下来的人做深。真觉得分档不对,回去改大纲,别在这里悄悄改一个不一样的
- 主角组内部可以细分。outline 的
lead是「男女主 + 主反派」一整组,对应protagonist与major两档,seed 一律给protagonist;照seedNote里的定位把主角之外的改成major,这不算推翻分档
没有 outline.json 也照常跑,本 skill 不依赖它——跳过 seed,从 Step 2 开始自己从原文拆角色表。
Step 2 — 分块
node {baseDir}/scripts/novel-characters.mjs chunk <book.txt> <workdir>
打印 {"chunks": N, ...}。
- N == 1:跳过 Step 3,直接在当前会话读原文做第一趟,结果自己写成
<workdir>/roster-00.json - N > 1:进 Step 3
truncated: true:明确告诉用户尾部没扫到,别闷着
Step 3 — 第一趟扫描(仅 N > 1)
当前环境支持子代理就并发(Claude Code 的 Task、codex 的 subagent):每块一个子代理,所有调用放在同一条消息里才是真并发。不支持就一块一块串行读,结果一样,只是慢。
每个子代理的任务:
- 读
{baseDir}/references/roster-pass.md,照它执行 - 读
<workdir>/chunk-NN.txt - 把 roster JSON 写到
<workdir>/roster-NN.json - 只回一句「done NN,抽到 X 个角色」
Step 4 — 归并 + 复核
node {baseDir}/scripts/novel-characters.mjs merge <workdir> | tee <workdir>/merged.json
落到 merged.json 不只是留档:Step 6 的 assemble 靠它拿同档角色的戏份顺序。
按名字+别名精确收敛(某块把「陆」列成「陆行远」的别名,两条就并成一个人),notes 累加、quotes 去重,按出现块数降序——出现的块越多戏份越重。
输出是 { "characters": [...], "mergeCandidates": [...] }。mergeCandidates 要逐条复核:精确匹配只能收敛两块恰好写了相同称呼的情况,剩下的是语义判断,脚本做不了。候选来自名字包含关系(「陆」⊂「陆行远」)——是强信号不是判决,同姓的父子、兄弟就不能合。候选之外你自己看出来的同人(「陆先生」和「行远」没有包含关系,不会进候选)也要合。
要合并就写一份 merges.json 再落地:
{ "merges": [{ "keep": "陆行远", "absorb": ["陆", "陆先生"] }] }
node {baseDir}/scripts/novel-characters.mjs merge <workdir> --apply merges.json | tee <workdir>/merged.json
keep/absorb 用名字或任一别名定位都行,找不到会直接报错。输出仍带 mergeCandidates,剩下的都确认是不同的人(或清空)再进下一步。没有要合的就直接往下走——但 merged.json 必须留着。
Step 5 — 选角
取前 N 位。默认 30,用户说了就听用户的。剩下的角色在最后汇报里提一句「还识别出 X 位没做画像」。
Step 6 — 第二趟出卡
每个角色一份,同样能并发就并发。
每份任务拿到:
{baseDir}/references/profile-pass.md和{baseDir}/references/schema.md(读它们,照着做)- 报告语言
lang(Step 0 定的) - 该角色归并后的
name/aliases/notes/quotes - 同批其他角色的名字(避免长相声线撞车)
角色卡 JSON 写到 <workdir>/card-<slug>.json。断点续跑:card-<slug>.json 已存在的角色不必重跑。
同时写一段故事摘要:用 lang 指定的语言,3–5 句,交代时空背景、核心情境、这几个人聚在一起的由头。短篇直接从原文写;长篇从各块的 roster note 归纳。不剧透结局,不写成推荐语。写到 <workdir>/summary.txt。非内置语言的话,把 Step 0 翻好的 ui 整块存成 <workdir>/ui.json。
然后合成 cast.json——用 assemble,不要手拼(手拼会丢字段、写错顶层键):
node {baseDir}/scripts/novel-characters.mjs assemble <workdir> \
  --source <书名> --lang <lang> --style <style> \
  --out <输出目录>/<书名>-cast.json
坏卡会被逐个点名——哪份 card-*.json 坏了就只重跑那个角色,其他不用动。
同档角色的先后是戏份顺序,来自 Step 4 留下的 <workdir>/merged.json(assemble 自动读,也可用 --order 指别的文件)。报告左栏「按戏份排序」的序号就靠它——看到「同档角色将按文件名序」的警告说明 merged.json 丢了,回 Step 4 重新生成。
Step 7 — 校验 ⛔ 不能跳
node {baseDir}/scripts/novel-characters.mjs validate <cast.json> <book.txt>
记得带上 --lang(Step 0 定的)。检查:结构、importance 枚举、引文逐字、出图提示词不含人名、语言分工(人类字段跟随 lang、出图/TTS 提示词永远英文)、以及非内置语言必须带 ui。
有违规就按报错逐条修,改完重跑,直到通过。 这四类错模型真的会犯——这套检查就是被真实输出打出来的。
Step 8 — 出图(可选,每个角色都出)
每个角色一张,用 image.sheet,落到 ./images/<slug>-sheet.png。一张横构图内部左右分栏:
┌──────────┬────────────────────────────┐
│  半身像   │   正视    侧视    背视       │
│ (证件照) ├────────────────────────────┤
│  面部基准  │  细节 · 细节 · 细节 · 细节   │
│   ~34%   │            16:9            │
└──────────┴────────────────────────────┘
左栏半身像是面部设计基准,右上三视图的脸照它画,右下是关键细节的小特写。两条硬要求:三视图的脸必须与半身像一致(否则一张图两个长
阅读完整来源 ↗先看看实际效果
浏览作者提供的图片与示例。打开原始文件,可查看完整尺寸的作品和动图。