native-subtitle-quote-image
将本地视频或用户有权处理的在线视频,经过来源获取、文字稿定位、选题选句、精确取帧、紧凑裁切、3:4 拼图和逐张质检,制作成视频字幕社交长图。支持两种明确分开的输出:保留画面内已烧录字幕的原生字幕模式,以及把已审核的时间点与台词绘制到真实视频帧上的脚本字幕模式。用户要求原生字幕截图、字幕帧拼图、YouTube 金句长图、台词截图、不重绘字幕、自定义中文台词,或调整主图比例、字幕区域、台词间隔和美感时使用。
chengyi-ai · 已有 AI 审核记录
安装与使用
运行命令前先阅读来源与依赖说明。复制命令不会自动安装或执行。
npx skills add chengyi-ai/native-subtitle-quote-image --skill native-subtitle-quote-image技能说明
name: native-subtitle-quote-image description: 将本地视频或用户有权处理的在线视频,经过来源获取、文字稿定位、选题选句、精确取帧、紧凑裁切、3:4 拼图和逐张质检,制作成视频字幕社交长图。支持两种明确分开的输出:保留画面内已烧录字幕的原生字幕模式,以及把已审核的时间点与台词绘制到真实视频帧上的脚本字幕模式。用户要求原生字幕截图、字幕帧拼图、YouTube 金句长图、台词截图、不重绘字幕、自定义中文台词,或调整主图比例、字幕区域、台词间隔和美感时使用。
视频字幕拼图
先判断字幕来源,再选模式。不要把两种模式混为一种,也不要默默从原生字幕切到绘制字幕。
非阻塞版本检查
每个新任务开始、处理素材之前运行一次:
python3 "<SKILL_DIR>/scripts/check_update.py" --json
- 脚本从 Skill 内的
VERSION读取本地版本,只访问本项目的 GitHub Latest Release;默认 24 小时内复用一次缓存。 - 结果为
update_available时,用一句话告诉用户当前版本、最新版本和 Release 链接,然后继续当前任务。只提醒,不自动更新、不覆盖本地 Skill。 - 结果为
up_to_date时无需打扰用户。结果为unavailable时也不要阻塞当前任务;若只是运行环境禁止联网,可申请对 GitHub API 的只读访问并用--force重试一次,未获授权就继续任务。 - 缓存只包含检查时间、最新版本号和 Release 链接,不写入仓库,也不记录账号、素材或使用行为。
模式路由
| 条件 | 模式 | 成品文字来源 | 命令 |
|---|---|---|---|
| 关闭播放器 CC 后,截图里仍有字幕;用户要求保留原字幕 | 原生字幕模式 | 视频画面像素 | render |
| 视频没有需要的烧录字幕,但用户要求把经确认的台词、翻译或观点排成案例风格 | 脚本字幕模式 | 已审核 JSON 中的 text | render-script |
- 原生模式不得 OCR 后重绘、翻译、改写或覆盖字幕。
- 脚本模式必须明确称为“脚本字幕”或“后期绘制字幕”,不得宣称文字是画面原字幕。
- 脚本台词必须能回到原视频、用户稿件或其他明确来源复核;不编造人名、数据、引语或翻译含义。
- 用户只说“保留原字幕”时,不能因为原字幕难处理就转脚本模式。
按任务读参考文件
- YouTube 等 URL:先读 references/yt-dlp-and-transcripts.md,获取用户有权处理的视频、元数据和辅助时间轴。URL 任务不能在一次公开请求失败后直接退回“只支持本地视频”:若 YouTube 返回机器人登录验证、年龄验证或用户自己的非公开视频限制,先说明原因并取得授权,再按参考文件用
yt-dlp --cookies-from-browser chrome继续。 - 读长视频 → 选题 → 写文章/帖子 → 配图:读 references/end-to-end-workflow.md。
- 台词条太高、间隔太宽、缺少美感:读 references/visual-style.md。
- 本地短视频且时间点已确定:直接执行下面的核心流程。
环境与路径
将 <SKILL_DIR> 解析为当前 SKILL.md 所在目录的绝对路径;不要假设 Agent 的工作目录就是 Skill 目录。
# 本地原生字幕
python3 "<SKILL_DIR>/scripts/check_environment.py"

# 中日韩脚本字幕
python3 "<SKILL_DIR>/scripts/check_environment.py" --script-mode

# URL + 脚本字幕
python3 "<SKILL_DIR>/scripts/check_environment.py" --url-mode --script-mode
核心依赖为 Python 3.10+、Pillow,以及 FFmpeg 或 imageio-ffmpeg。URL 模式另需 yt-dlp 和 YouTube 完整解析所需的 JavaScript runtime。环境检查只报告状态;缺失时先说明用途并取得授权,再运行:
python3 -m pip install -r "<SKILL_DIR>/requirements.txt"
不擅自修改系统 Python、shell 配置、浏览器 Cookies 或包管理器。Chrome Cookie 只是在无 Cookie 请求被 YouTube 登录验证拦截后的受控恢复路径;首次读取前必须说明用途并取得用户授权。
共同的默认版式
- 默认输出 3:4、1440×1920。
- 默认使用 5 个严格递增的时间点:第一帧是主画面,其余四帧是字幕条。
- 4 个字幕条时,主画面约占 70%,每条约占 7.5%,条间距为 0。台词较少时把多余高度留给主画面,不拉高字幕条。
- 只有自动布局确实不适用时,才传
--hero-fraction。 - 不覆盖已有成品。只有用户明确要替换时才添加
--overwrite。 - 源视频低清时可输出 1440×1920 版面,但必须说明这不等于真实清晰度提升。
共同前半流程
1. 检查来源与字幕类型
确认本地视频或 URL,素材使用权,视频时长、语言和目标图片数。用真实截图判断字幕是烧录字幕还是独立字幕轨,不能只看是否下载到 VTT/SRT。
时间点不明时,先生成候选帧总览:
python3 "<SKILL_DIR>/scripts/native_subtitle_stitch.py" sample VIDEO \
  --out candidate-contact-sheet.jpg
已有文字稿候选时间点时,围绕每个点生成前、中、后三帧:
python3 "<SKILL_DIR>/scripts/native_subtitle_stitch.py" sample VIDEO \
  -t 61.2 -t 68.9 -t 74.5 -t 82.0 -t 88.4 \
  --around 0.8 --out focused-candidates.jpg
2. 选主题与稳定帧
一张图只表达一个连贯观点。候选句需要语义递进,并且每个时间点都能回到视频验证。避免空字幕、同句重复、字幕切换残影、转场、黑帧、广告贴片、播放器 UI 和人物闭眼。
原生字幕模式
3A. 预览字幕区域
单行字幕从 0.78–0.96 开始;两行字幕或位置偏高时,先预览再扩大到例如 0.62–0.96。
python3 "<SKILL_DIR>/scripts/native_subtitle_stitch.py" band VIDEO -t 61.2 \
  --band-top 0.78 --band-bottom 0.96 --out band-preview.jpg
4A. 建立 manifest 并渲染
{
  "images": [
    {
      "title": "模型独立工作时长正在快速增长",
      "times": [61.6, 69.3, 75.0, 82.4, 88.8]
    }
  ]
}
python3 "<SKILL_DIR>/scripts/native_subtitle_stitch.py" render VIDEO \
  --manifest manifest.json --out-dir OUTPUT_DIR \
  --aspect 3:4 --width 1440 \
  --band-top 0.78 --band-bottom 0.96
title 只用于文件名,不画进图片。times 必须来自已回看的稳定帧。输出包含逐张 JPG、原生字幕时间点.json 和 final_contact_sheet.jpg。
脚本字幕模式
3B. 建立已审核的时间点 + 台词 JSON
{
  "lines": [
    {"t": 61.6, "text": "第一句已核对台词"},
    {"t": 69.3, "text": "第二句已核对台词"},
    {"t": 75.0, "text": "第三句已核对台词"},
    {"t": 82.4, "text": "第四句已核对台词"},
    {"t": 88.8, "text": "第五句已核对台词"}
  ]
}
t必须严格递增且小于视频时长。text必须是已核对的单行台词;过长时拆句,不靠极小字号硬塞。- 翻译台词要先核对含义、人名、数字和专有名词。
- 第一帧优先表情、手势和构图,其余帧优先台词连贯与背景可读性。
4B. 渲染脚本字幕
python3 "<SKILL_DIR>/scripts/native_subtitle_stitch.py" render-script VIDEO \
  --script script.json --out OUTPUT.jpg \
  --aspect 3:4 --width 1440
脚本会尝试 macOS、Windows 和 Linux 常见 CJK 字体。无法自动找到时,用 --font /path/to/font.ttc 指定已获授权的字体。需要调整字幕条在原帧中的垂直采样位置时,使用 --band-center;不要把它当作行距参数。
逐张质检与有界返工
先看缩略总览,再打开每张原尺寸 JPG。
- 字幕完整、稳定、无重复,时间顺序与原视频一致。
- 原生模式没有改字;脚本模式的文字与已审核 JSON 一致。
- 主体完整,没有异常切脸、巨大空白、无关 UI 或变形。
- 默认四个字幕条时,主画面约占 68–72%,条与条紧凑相接,没有额外间距。
- 脚本模式的字号、描边、对比度在原尺寸与手机缩略图中都可读。
- 文件数量、尺寸、比例、JSON 和总览一致。
发现问题时只调整对应变量:时间点通常移动 0.3–1.5 秒;原生字幕被裁时调整 band 边界;台词条太高时先恢复自动布局;文字过长时先拆句。连续三轮仍找不到稳定画面时,换片段或报告限制,不无限微调。
与其他工具或 Skill 协作
yt-dlp:获取用户有权处理的在线视频、元数据和字幕轨;不负责最终渲染。- 字幕轨或 Whisper:生成带时间戳的内容索引。原生模式只用它定位;脚本模式可把已复核文字写入 JSON。
- 视频理解、选题或内容分析 Skill:提名主题、时间范围和句子顺序。
- 写作 Skill:产生配套文章或帖子;它不能在原生模式中改变画面字幕。
- 本 Skill:管理最终时间点、真实视频帧、字幕来源标识、拼图和视觉 QA。
复用上游已经下载的视频、文字稿和缓存,不重复消耗网络或转写成本。不假设用户一定安装了某个命名 Skill;缺少上游 Skill 时,自行完成最低限度的文字稿阅读和主题选择。
停止条件
- 用户没有下载、处理或发布来源素材的权限。
- 链接需要绕过 DRM、付费墙、地区限制或其他访问控制。
- 用户要求原生字幕,但画面没有烧录字幕;此时先说明,只有用户同意才转脚本模式。
- 原生模式找不到字幕完整稳定的帧。
- 脚本模式的台词或翻译尚未核对,或没有可用 CJK 字体。
- 源画质、遮挡或 UI 严重到无法达到可读交付。
登录、年龄验证、机器人验证或用户自己的非公开视频需要 Cookies 时,必须先取得授权;授权后优先让 yt-dlp 通过 --cookies-from-browser chrome 临时读取用户自己的已登录会话,而不是让用户粘贴密码或导出 Cookie 文件。不得把浏览器数据写入仓库。
交付
提供输出路径、逐张成品、时间点/lines JSON、总览图与已完成的视觉和技术检查。明确标记使用的字幕模式。只有用户需要分享包时再生成 ZIP;不得把未逐张打开检查的图片报告为完成。
先看看实际效果
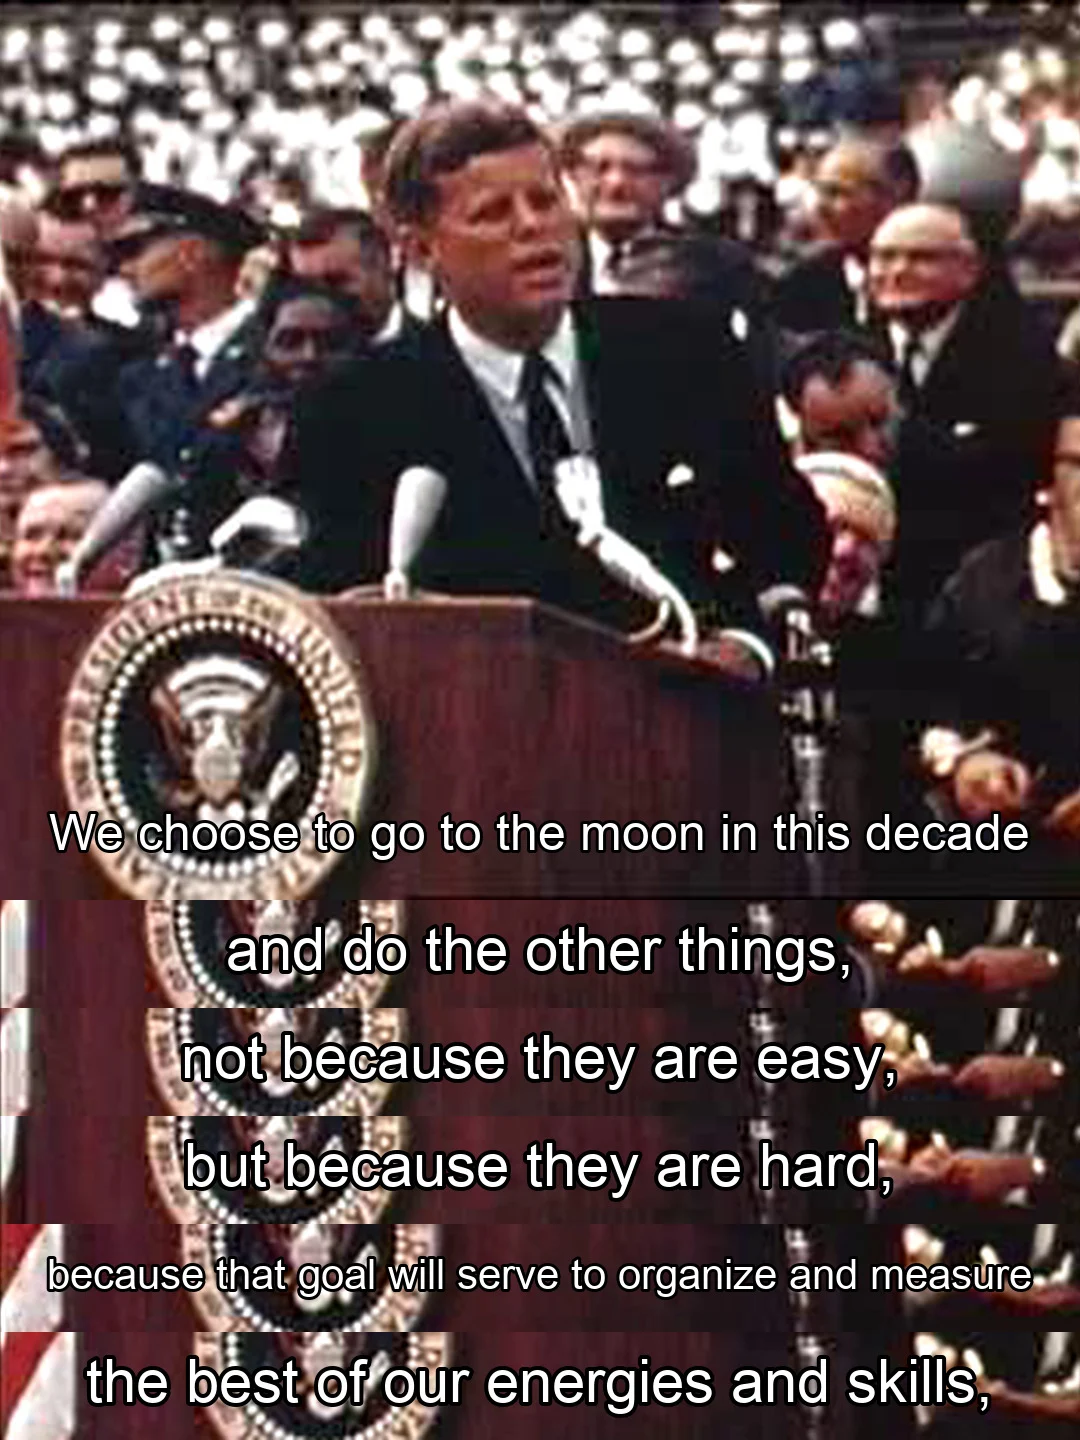
肯尼迪“我们选择登月”:真实演讲金句长图
本站制作 · 本站于洛杉矶时间 2026 年 10 月 6 日,使用目录已收录的固定版本 v2.1.1 CLI 制作。影像来自 NASA Shuttle–Mir 历史档案;肯尼迪图书馆将其 NASA 演讲影片标为公有领域;引语对照肯尼迪图书馆官方文字稿。本站负责片段选取、台词核对、选帧和实际 Skill 渲染。字幕由脚本模式后期绘制。已打开原尺寸成品检查六行字幕与人物画面。本次记录覆盖一次本地英文脚本渲染,未测试其他模式、安装与通用兼容性,也不表示演讲者或 NASA 的背书。